


Unicode è la codifica più utilizzata sul Web

Sul Web il tasso d'adozione della codifica Unicode ha superato quello dello standard ASCII, parola di Google
di Fabio Gozzo pubblicata il 08 Maggio 2008, alle 11:45 nel canale WebMark Davis, senior international software architect di Google, è di recente intervenuto sul blog ufficiale della compagnia di Mountain View con alcune interessanti considerazioni sugli standard di codifica dei caratteri attualmente utilizzati sul Web.
Basandosi su informazioni interne della compagnia, Davis afferma che attualmente lo standard più popolare per la codifica dei caratteri delle pagine Web non è più l'ASCII (American Standard Code for Information Interchange) ma l'Unicode.
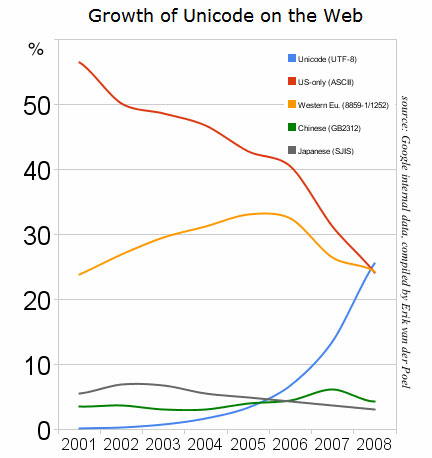
Fonte: Google
In accordo con i dati rilasciati da Google, il sorpasso della codifica Unicode è avvenuto lo scorso dicembre e, nonostante il vantaggio sia tuttora minimo, è frutto di una crescita significativa è costante avvenuta nell'arco degli ultimi 3 anni.
La lenta ma graduale migrazione verso Unicode è in atto ormai da molto tempo e non è certo una sorpresa. Il sistema di codifica ASCII esteso utilizza 8 bit di memoria per memorizzare un singolo carattere ed è in grado di rappresentare solamente 256 simboli. Questa limitazione del formato ha portato alla nascita di diverse versioni dello standard al fine di soddisfare le diverse esigenze dei ceppi linguistici esistenti.
Per far fronte alla frammentazione e ai problemi di conversione dovuti all'esistenza di differenti versioni dello standard ASCII, è nato Unicode, un formato che si prefigge di poter rappresentare tutti i caratteri esistenti. Questo sistema di codifica è stato infatti pensato per poter essere facilmente espanso ed aggiornato, garantendo sempre la retrocompatibilità con le precedenti versioni. Attualmente sono utilizzate le codifiche a 8, 16 o 32 bit, indicate rispettivamente con le sigle UTF-8, UTF-16 e UTF-32.
La convergenza del Web verso il più recente standard di codifica Unicode riduce notevolmente le problematiche legate alla visualizzazione di differenti alfabeti, tuttavia ha come svantaggio una maggiore occupazione di memoria rispetto allo standard ASCII per la memorizzazione di un singolo carattere.


 Recensione REDMI Note 17 Pro: il midrange con batteria da 8.340 mAh e ricarica veloce
 Insta360 Luna Ultra: la potenza del sensore da 1 pollice incontra la portabilità estrema
 Marvel's Wolverine, la recensione: Logan torna protagonista in un'avventura brutale e intensa
 DAZN Full in sconto a partire da 19,99 euro/mese, solo per questo weekend
 iPhone 18 Pro disponibile su Amazon a 1.489€: crollano i prezzi di iPhone 17 Pro Max a 1.299€ e iPhone 16 a 699€
 ECOVACS T90 OMNI a 439€ e T90 MAX OMNI a 449€: robot aspirapolvere con rullo OZMO Roller 3.0 e aspirazione da 30.000 Pa
 Questa Proscenic è la scopa elettrica da acquistare al volo, oggi a 113€: 650W, 55.000Pa e 70 minuti di autonomia
 Microsoft Defender: falso allarme sull'antivirus disattivato corretto con una patch
 Aerei in volo e truppe pronte all'assalto: la clamorosa cantonata dell'IA che ha rischiato una guerra
 Usano Claude per hackerare OpenAI: ricercatori di Hacktron accedono ai repository privati
 RatHat: il nuovo malware Android usa il tuo smartphone tramite l'intelligenza artificiale
 Domanda di petrolio in calo di 2,5 milioni di barili: il 'merito' è della crisi di Hormuz
 Il meglio delle offerte weekend Amazon appena aggiornate: da 21€ in su, sono tutte occasioni di vero risparmio
 Dopo oltre 100 anni di tentativi, l'IA decritta una comunicazione tedesca della Prima Guerra Mondiale
 Speciale robot aspirapolvere in offerta Amazon: ECOVACS, Dreame, MOVA e roborock da 276€ con aspirazione fino a 35.000 Pa
 L'IA sta cancellando i lavori junior? Il vero rischio è restare senza senior
 Debutta Chery Italia: non più solo Omoda & Jaecoo, una gamma completa con la sorpresa Chery Q | Video







24 Commenti
Gli autori dei commenti, e non la redazione, sono responsabili dei contenuti da loro inseriti - infoCosì poi servivano 20 versione del sito...
quando è che ci passa anche hwupgrade?
Tutte le altre lingue hanno gli accenti, e lettere "strane" per non parlare delle lingue con scrittura diversa dai caratteri romani...
Per me sono pochi i siti che usano Unicode...
Occupa più byte solo quando si passa dal 128° carattere in poi, prima occupa 1B. In base al valore dei bit più significativi si sa quanti byte formano il prossimo carattere.
Se usiamo solo caratteri presenti in ASCII standard la dimensione del testo sarà identica. Se usiamo solo caratteri NON presenti sarà almeno il doppio.
Non è uno svantaggio la dimensione dei caratteri perchè non c'è altro modo per rappresentare i caratteri se non aumentando la quantità di bit necessari per descriverli. Il vantaggio è invece l'eliminazione dei byte non necessari alla rappresentazione.
UTF-32 contiene caratteri lunghi 8, 16, 24 E 32bit.
Occupa più byte solo quando si passa dal 128° carattere in poi, prima occupa 1B. In base al valore dei bit più significativi si sa quanti byte formano il prossimo carattere.
Se usiamo solo caratteri presenti in ASCII standard la dimensione del testo sarà identica. Se usiamo solo caratteri NON presenti sarà almeno il doppio.
Non è uno svantaggio la dimensione dei caratteri perchè non c'è altro modo per rappresentare i caratteri se non aumentando la quantità di bit necessari per descriverli. Il vantaggio è invece l'eliminazione dei byte non necessari alla rappresentazione.
UTF-32 contiene caratteri lunghi 8, 16, 24 E 32bit.
*
UTF Rulezz
Occupa più byte solo quando si passa dal 128° carattere in poi, prima occupa 1B. In base al valore dei bit più significativi si sa quanti byte formano il prossimo carattere.
Se usiamo solo caratteri presenti in ASCII standard la dimensione del testo sarà identica. Se usiamo solo caratteri NON presenti sarà almeno il doppio.
Non è uno svantaggio la dimensione dei caratteri perchè non c'è altro modo per rappresentare i caratteri se non aumentando la quantità di bit necessari per descriverli. Il vantaggio è invece l'eliminazione dei byte non necessari alla rappresentazione.
UTF-32 contiene caratteri lunghi 8, 16, 24 E 32bit.
Interessante. Visto che sembri ferrato in materia, ti faccio una domanda: apro un documento di testo in formato ANSI con Notepad (sono su una macchina con Windows XP), lo salvo in Unicode e la dimensione del file raddoppia. Il file contiene solo caratteri ASCII standard (ho fatto una prova scrivendo una serie di aaaaaaaaaaaaaa bbbbbbbbbbbbb cccccccccccc copiata ed incollata n volte per renderlo un po' corposo). Colpa di come Notepad / Windows gestiscono Unicode o dipende da qualcos'altro?
Devi effettuare il login per poter commentare
Se non sei ancora registrato, puoi farlo attraverso questo form.
Se sei già registrato e loggato nel sito, puoi inserire il tuo commento.
Si tenga presente quanto letto nel regolamento, nel rispetto del "quieto vivere".